共 2 篇
通过AI辅助,我成功的爬取了一个资源网站的cos图.一共编写了近4小时的原程序,最后通过AI来优化程序并把.py文件打包成.exe文件.(本爬虫完全遵守目标网站的爬虫协议) 最…
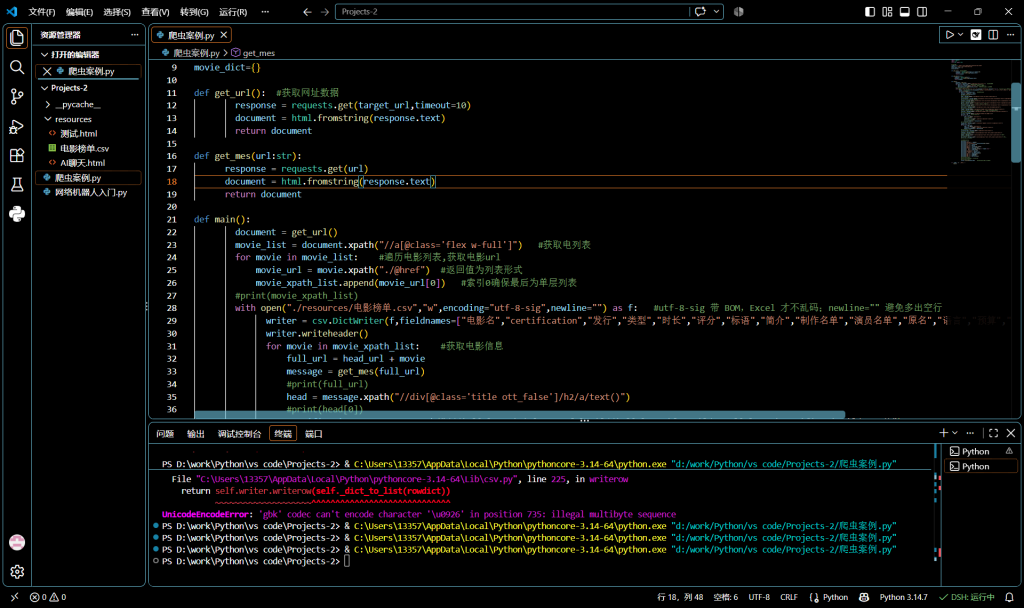
学了Python的爬虫,做了一个爬取TMDB的爬虫程序(遵循爬虫协议).可以爬取电影名,发布时间,演员表,简介等数据. 展示: 效果展示: 总体效果还行,开发了3小时左右(还不…
 星汐博客网